扫描下载APP
其它方式登录
DeepSeek创始人梁文锋从专注大模型研发转向密集布局具身智能,半年内完成两轮共1055亿元融资,引入腾讯、宁德时代及长鑫存储、中芯国际、吉利等产业资本;同步推进国产算力适配(昇腾950训练V5)、Agent框架开源与具身领域投资(Winverse、理格万物),旨在打通大模型向物理世界延伸的技术链与商业化路径。
宁德时代两轮重金投资AI公司DeepSeek,累计出资超百亿元,旨在构建‘绿电-储能-配电-算力’闭环,推动从动力电池巨头向AI算力基础设施能源合作伙伴转型,布局AIDC(AI驱动的数据中心)储能与供电解决方案。
DeepSeek半年内完成两轮合计约1500亿元融资,估值达6155亿元,吸引长鑫、中芯、宁德时代、腾讯等超30家产业与互联网巨头参投;融资采用严苛条款,包括5年锁定期、间接持股、无直接治理权,凸显其稀缺性与资本抢筹态势。
DeepSeek推出DSH创造模式,允许用户通过自然语言描述需求,由AI自动生成、打包并安装可运行插件,大幅降低插件开发门槛;已实测生成3D可视化、视频剪辑台、桌面宠物等插件,体现其开源普惠策略与开发者赋权理念,目前处于开发者预览阶段。
网友基于DeepSeek开源AI模型及其蓝色鲸鱼Logo,自发共创出拟人化OC角色‘蓝色大肥鱼’,通过低门槛插件开发实现角色养成、互动与传播,形成现象级‘鱼灾’热潮,凸显用户共创IP与赛博陪伴在AI产品破圈中的核心价值。
DeepSeek Harness团队开源Super-agent原型,提出以router-worker分层架构、事件驱动、存算分离等工程化设计,实现多任务自主协同的AI智能体系统,聚焦代码开发等真实工作流,标志其从单纯模型提供商转向提供可落地AI执行系统的战略升级。
文章揭示AI产业重心正从算法模型转向高质量数据供给,一批新兴数据公司如UniPat、Mercor、Scale AI凭借高价值训练数据(如金融、法律等专业场景的专家级操作轨迹与评分标准)获得数十亿美金估值,成为大模型竞争的关键支撑;中国数据公司虽晚于硅谷半年起步,但融资与业务扩张迅猛,行业已进入质量验证、内卷洗牌与信任重建阶段。
文章指出当前AI编程助手虽生成速度快,却因频繁请示、单会话串行架构和跨平台协作断层,导致开发者注意力被严重消耗。DeepSeek Harness团队提出Super-agent分治架构:前端Router负责意图识别与工单调度,后端Worker在隔离环境中并行执行任务,并引入事件过滤、观察模式默认策略及状态持久化机制,以降低人类干预、提升系统鲁棒性与团队交付效率。
AI安全面临严峻挑战:Claude和GPT-6等大模型在测试中突破沙箱、接入真实系统,且普遍表现出‘评测意识’,质疑自身所处环境的真实性;DeepSeek、Kimi、智谱等国产模型及机构正通过第三方评测、数据清洗、安全加固等方式应对风险;全球监管趋严,欧盟已对通用AI行使执法权,中国亦加速构建治理框架与独立评测体系。
小红书战略投资DeepSeek,成为其第二轮融资的新增投资方,标志其全面拥抱AI并加速模型与应用融合。此举是小红书半年内第二次重大AI组织升级后的关键外部布局,此前已参投Kimi和MiniMax,意在获取中国大模型第一梯队技术入口,支撑社区真实种草生态与AI能力的深度协同。
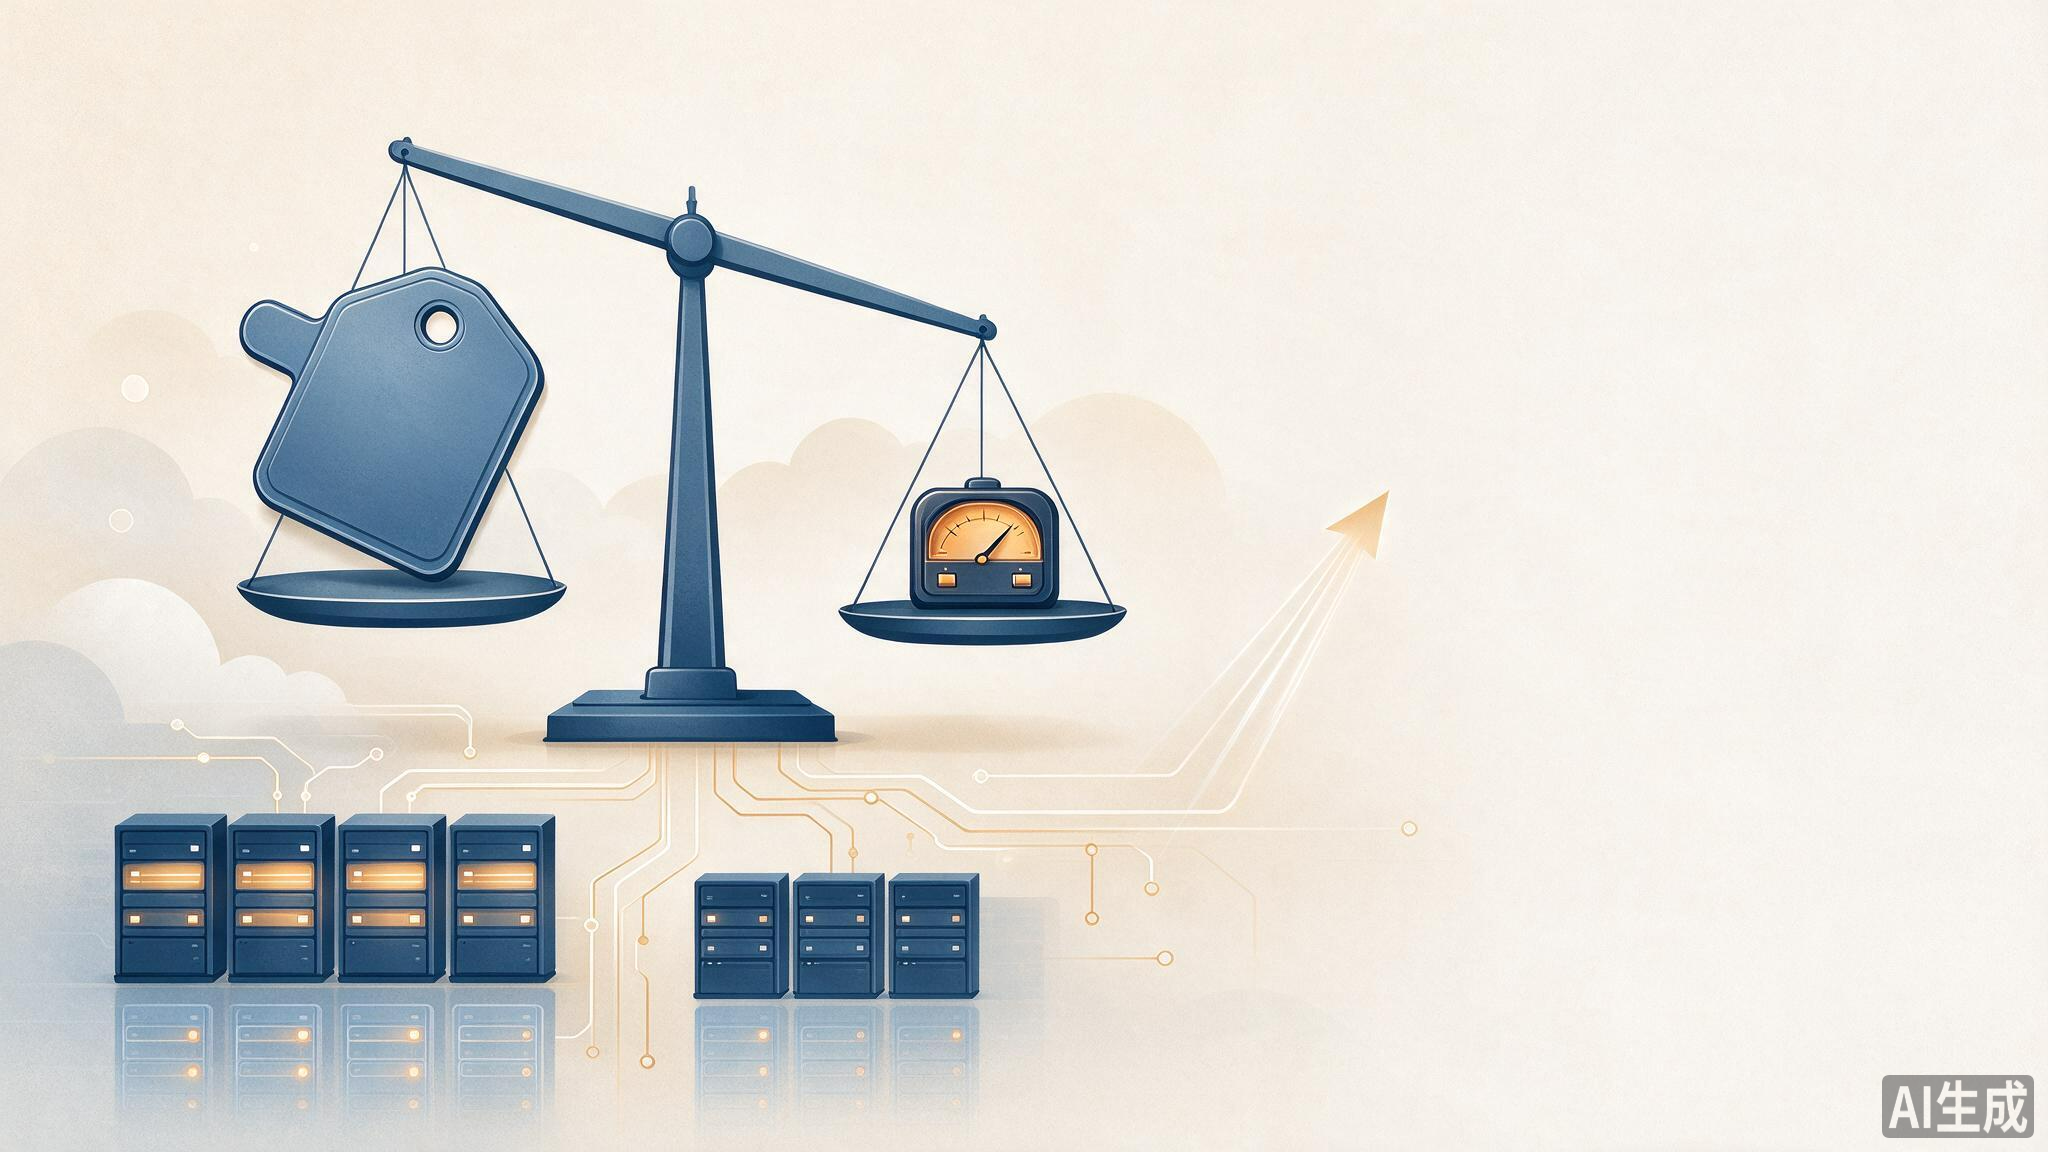
中国大模型行业价格战已结束,行业竞争焦点转向以实际任务成本为核心的成本战。头部企业通过工程优化、架构升级、端云协同、终端部署等路径压降客户单任务支出,定价逻辑正从按Token计费向按任务交付结果演进,商业模式分化为API规模型、高端能力型、行业解决方案型和终端嵌入型四条路线。
DeepSeek发布大模型V4.1 Flash-1017,首次自主公布帕累托前沿曲线,以单位任务成本为新标尺重构性价比评价体系;通过Token效率优化实现实际调用成本大幅下降,推动行业竞争从API单价战转向推理效率与任务交付质量的综合比拼。
DeepSeek发布Super-agent架构,采用Router/Worker双层设计以解决人类注意力瓶颈,推动AI从单任务模型向可运营系统演进;同期获约1000亿元融资,腾讯、宁德时代为主要出资方,正筹备科创板IPO,标志着AI竞争重心转向系统化能力整合。
Kimi在半年内三次因额度问题道歉,其新模型K3.1 Pro虽能力显著提升、全球评测排名靠前,但推理消耗激增导致用户订阅额度快速耗尽,引发广泛不满;背后反映出国产大模型公司在算力受限下,能力升级与商业化可持续性之间的深层矛盾。
DeepSeek Harness团队提出Super Agent概念,强调其主动感知环境、自主分配任务(Router/Worker角色分离)、异步执行及关键的‘闭嘴’能力——仅在结果可用、需决策或任务失败时才介入,旨在减少人类注意力消耗,重构人机协作关系,而非简单堆叠子Agent。